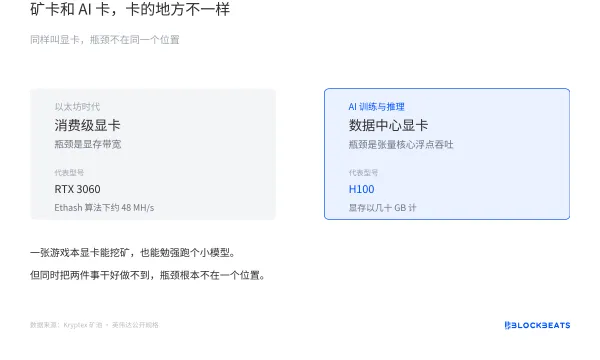
以太坊还是 POW 的那几年,矿工用的就是消费级显卡,算法叫 Ethash。一张 RTX 3060 在 Ethash 上大约 48 MH/s。当时确实有人就想过,既然挖矿和 AI 都靠显卡,能不能让同一张卡一边挖一边算模型。
这个想法没成,因为两件事卡的地方不一样。Ethash 吃显存带宽,算的是固定难度的哈希。AI 要的是张量核心的浮点吞吐和几十 GB 显存,主力是 H100 这类数据中心卡。一台游戏本上的显卡能挖矿,也能勉强跑个小模型,但同时干好两件事做不到。
Vitalik Buterin 在 2019 年给这件事下过一个判断,原话是如果能找到某种既有用又容易验证的计算,加密货币挖矿会成为社会的一笔巨大财富,但这大概是做不到的。
Pearl 声称它做到了。Vitalik 几年前的判断,被 Pearl 官网挂在显眼的位置。
Pearl 是一条独立的工作量证明公链,代币叫 PRL。矿工不反复算哈希,改做矩阵乘法,也就是神经网络每一层都在做的那种乘加。设计上,同一份 GPU 计算既出块发币,又产出可验证的 AI 计算。
官方对这件事有个说法,叫「能量、数据、货币在一次操作里」。比特币把能量和货币绑在一起,AI 把能量和数据绑在一起,货币化把数据和钱绑在一起。三样东西以前两两相遇,Pearl 想在一次矩阵乘法里让三者同时发生。
PoW 这条线安静了很久。上一批能让人坐下来认真讨论的新公链基本交卷在几年前,之后的热闹都在 L2、模块化和再质押那边,一条新 PoW 链本身就少见,现在流通市值 4.3 亿美金的 PRL,想讲一件什么事?
它想解决什么问题
比特币的工作证明有个特点,矿工算的东西和现实世界没有任何关系。同样一度电,拿去跑模型能出 token、能出图、能干活,很多人觉得拿去挖矿有点浪费。
真正的难点不在「有用」,在无许可。无许可的意思是,谁都能来挖,不用报名,也没有人审核资格。比特币的安全模型就建立在这一点上,不管你算的是什么,成本都一样。一旦工作量换成有现实价值的东西,矿工就有动机偷工,或者挑一种便宜的输入。所以问题不是能不能让挖矿有用,而是能不能让它有用,同时谁也偷不了工。
Pearl 自己的说法是,把比特币的随机哈希换成矩阵乘法,让 GPU 把工作证明当成 AI 负载的副产品来做。白皮书里直接用了「2-for-1」这个词。翻成大白话,以前一批 GPU 只有两个去处,要么挖矿一边烧电一边出币,要么跑模型一边烧电一边出 token,Pearl 想把这两个去处合成一个。
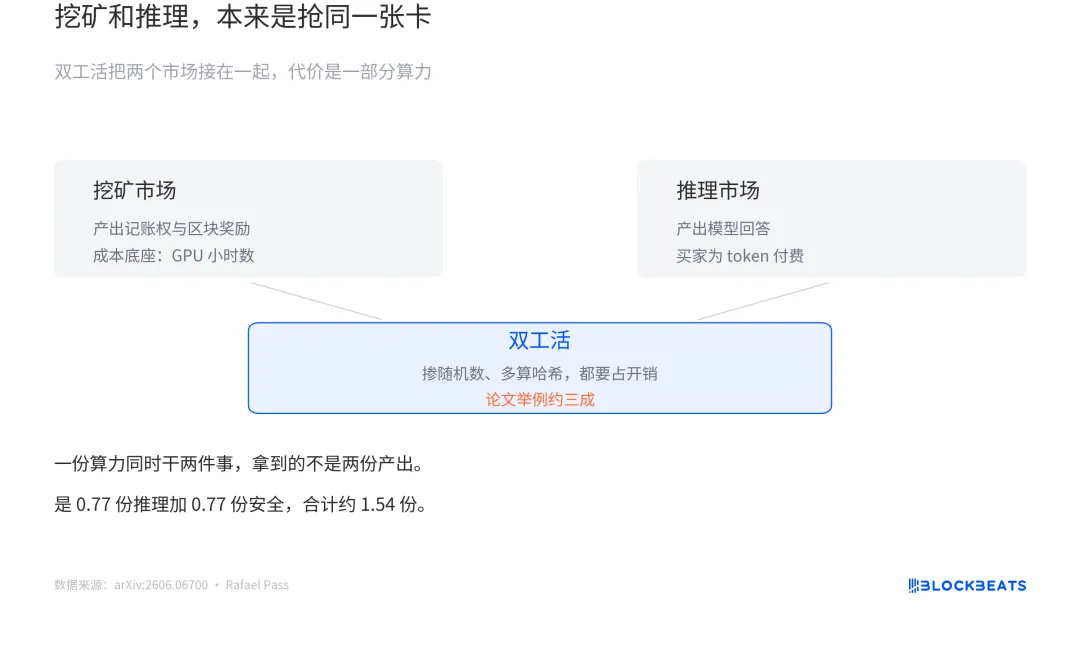
这个想法有人算细过。密码学研究者 Rafael Pass 的论文《The Economics of Proof-of-Useful-Work》把机器的活分成三种,纯挖矿、纯推理,还有同时产出两者的双工活。双工不免费,论文举例说一份算力同时干两件事,拿到的不是两份产出,是一份半左右。开销够小、代币被市场接受的规模够大,区块奖励就相当于给推理价格打了返点,把原本不会有人做的推理算力拉进来。这套推演在数学上挑不出毛病,麻烦在于它的三个变量,开销、币价、推理需求,没有一个是 Pearl 能自己决定的。论文脚注披露,作者是在为 Pearl Research Labs 提供咨询期间完成这项工作的。
Pearl的运转逻辑
要说清这套东西怎么转,得先把矩阵乘法这个词拆开。它不是 Pearl 造出来的,是一道很老的运算,神经网络里几乎每一层都在用它。
一张矩阵就是一张按行列排好的数字表格。两张表能相乘,条件是前一张的列数等于后一张的行数。结果表的每个格子,是前一张的一行和后一张的一列,一个对一个乘起来再全部加总。举个最小的例子,A 的第一行是 1 和 2,B 的第一列是 5 和 7,结果表左上角就是 1 乘 5 加 2 乘 7,等于 19。剩下的格子照这个规矩一个个填。
AI 模型里,一层运算可以写成「输入乘权重」。用户的一句话被切成向量,和这一层的权重表相乘,得到结果,再过一道非线性函数,交给下一层。模型越大表格越大,一次乘加的次数动辄上万亿。GPU 就是为这种整齐的乘加造的,这也是为什么挖矿卡和 AI 卡是同一类芯片。
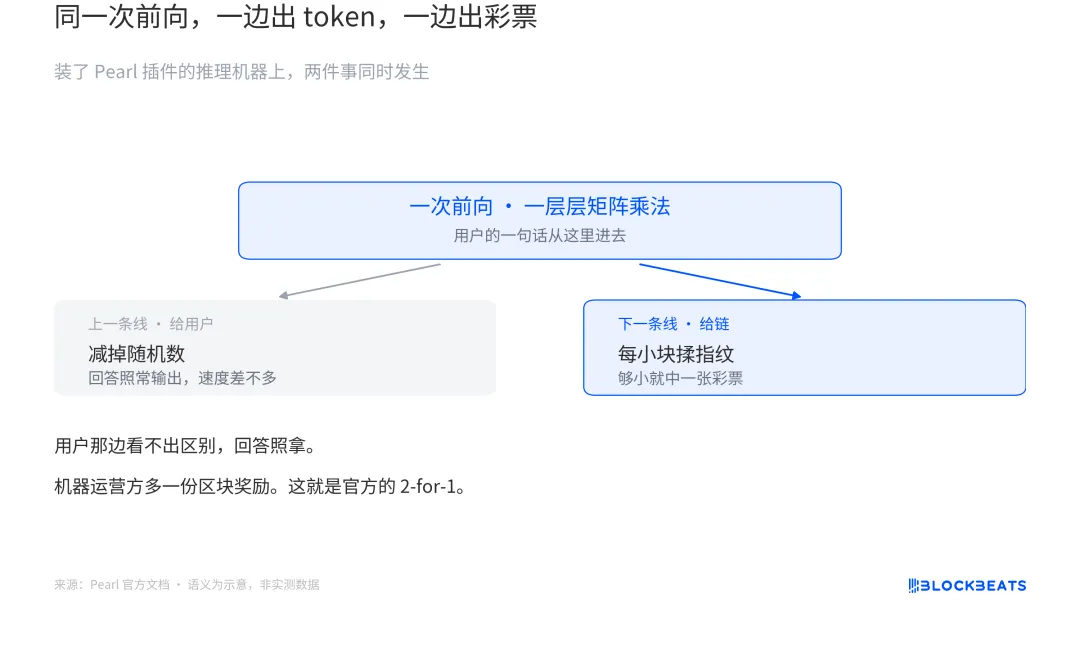
理想情况下,事情是这样的。有个人在网上问聊天机器人一个问题,服务器上的显卡开始跑模型,一层一层做矩阵乘法。如果这台机器装的是 Pearl 的插件、跑的是它认证过的开源模型,那么这些乘法在出回答的同时,还会被拿去碰运气。每算完一小块就揉一次指纹,指纹够小就中一张彩票,中了拿区块奖励。用户那边看不出区别,回答照拿,价格甚至可能便宜一点。同一批乘加,一边变成 token,一边变成币。
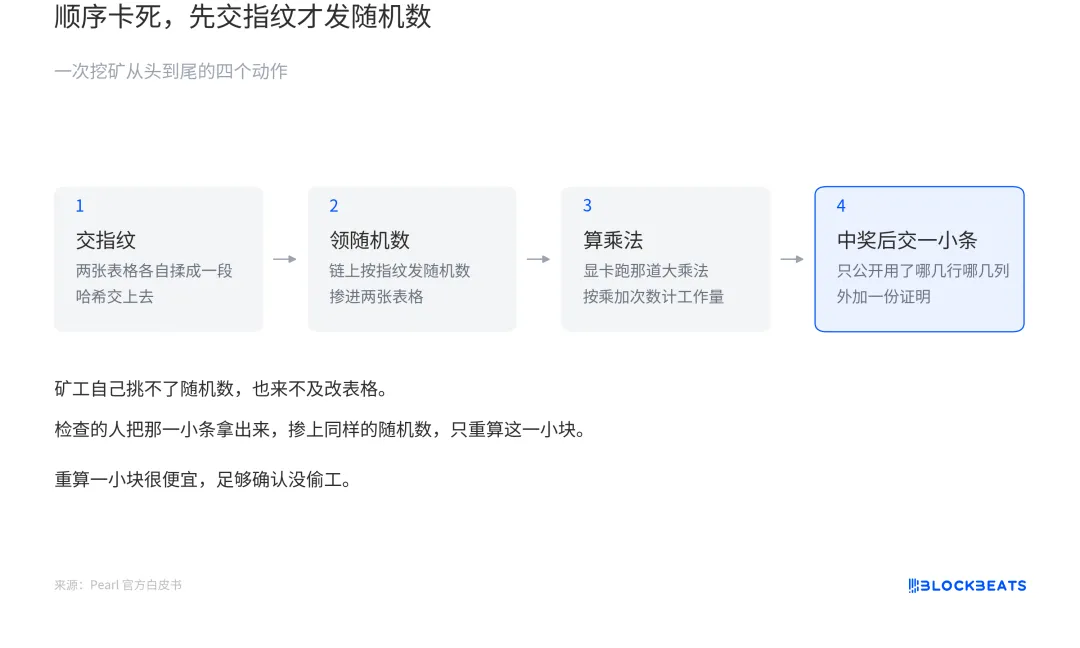
这套东西要成立,得先解决偷工。矿工手上就是两张表格,他要先把表格揉成一个指纹交上去。所谓揉指纹,就是拿这张表里的所有数字一起算一次哈希,压成很短的一小段。链上看过这个指纹,才会告诉他要往表格里掺什么随机数,顺序卡死,他想改表格也来不及。官方管这个动作叫加噪声,说白一点,就是往两张表格里掺进一堆随机数字,掺多少、掺在哪,由那个指纹决定,矿工自己挑不了。
不掺的话有捷径可走。干净的 A 乘 B,和掺过随机数的乘积之间,只差三个修正项,这三项数量级不小,算起来却很便宜。矿工手上本来就有干净的 A 和 B,他完全可以先把干净答案算好,再加这几个便宜的修正项凑出掺过随机数的答案,那道大乘法根本不用做。好比考试题目是 3987 乘 2913,学生早就背过答案,拿几个小数字凑一凑,看着像认真算过。
所以协议不要求矿工交出算好的结果,只要求他交出用到的那几行输入,加上一份证明。检查的人把这部分拿出来,掺上同样的随机数,只重算这一小块,看指纹对不对。重算一小块很便宜,足够确认他没偷工。如果这些表格涉及公司权重或用户数据,还可以再加一层零知识证明,证明确实算过,但不透露用的是哪两张表。
现在跑到哪一步了
去 Hugging Face 看,pearl-ai 这个组织下面有四个认证模型,Llama 3.3 70B、Llama 3.1 8B、Qwen3 30B 和 Gemma 4 31B。官方管它们叫「认证变体」,做法不是重新训练,是把同一批权重按 Pearl 的量化格式重新压一遍,让它能在插件里一边推理一边挖矿。精度损失很小,Gemma 4 31B 的 MMLU 从 90.93 降到 90.56。截至 2026 年 10 月 9 日,这四个模型近三十天的下载量从 195 到 6424 不等,点赞数分别是 0、3、5、6。
商业出口也有一条。2026 年 5 月,Pearl 和 Together AI 合作上了一个跑 Gemma 模型的接口,据 Together 的公告,调用价比普通接口便宜 25%,差价由代币的未来价值抵扣。
模型挂出来了,代码也开源了,然后就没有然后了。2026 年 6 月,研究者 Abhinaba Basu 的《The Usefulness Gap in Proof-of-Useful-Work》测了这件事。据当时全网算力约 24 EH/s,相当于约 32 万张 RTX 3090 级别的卡,估计耗电 112 兆瓦,而有用的 AI 计算产出是零。
作者抽查了 8012 个矿工工作单元,硬件全都具备推理能力,但主力矿机软件里,矩阵乘法相关的字符串有 4803 条,机器学习框架相关的有 0 条。他还自己写了个矿工程序,用随机数字填表格,在英伟达、AMD、CPU、苹果芯片上都跑通了,拿到矿池认可的份额,一共 44 个。一个人提供数据、让模型算出结果,和用同一张卡挖币,在设计里可以合一,在实际运行里是分开的。
那网络上实际在跑的是什么。据矿池 Kryptex 的页面,全网算力已经涨到 46.37 EH/s,难度 2.26 TH,出块约 203 秒,每块奖励 2271.03 PRL,每天产出约 96.6 万枚,币价约 1.30 美元。六个月里算力几乎翻了一倍,涨上来的这部分,绝大多数还是在填随机数字。市面上现在做的,主要就是这么一件事,买卡、插上、填随机数、等结算。
有什么问题
我们想象一下,食堂贴出告示,谁切够一百斤菜,谁就能领一份工资。切菜这件事本身是真的,刀工、力气、时间都得花。但告示只检查你有没有切够一百斤,不检查你切的是什么菜。于是有人拉来一车烂菜叶,切够一百斤,领走工资。他确实切了菜,力气也真的花了,只是厨房用不上这堆叶子。
Pearl 现在就卡在这里。协议检查的是表格的指纹对不对得上、结果是不是真等于两张表相乘、工作量够不够难度,正式设计里还有一层统计闸门,专门挡一眼能看出做过手脚的输入。这些它都查。它没有查的是,这两张表格是从哪来的。所以矿工完全可以自己造两张随机数字的表格,乘法一样难,指纹一样达标,一样能中奖,只是算出来的结果没有人要用。协议只认乘法关系,不认语义,「有用」在这里是商业问题,不是密码学保证。
这不是猜的。据前面那篇报告,被抽到的那批机器全都跑得动模型,矿机软件里却一行推理代码都没有,作者自己用随机数字填的表格也拿到了矿池认可的份额。目前全网算力在 45 EH/s 上下,绝大多数还是在填随机数字。
规模上的落差也可以这么看。论文给过一个反事实,如果这套设计真像宣传那样运转,当时那张 24 EH/s 的网每天本应产出约 770 万 GPU 小时的有用 AI 算力。论文还提了一个指标叫价值毁灭比,Pearl 实测是 1.0,和比特币持平,而 Filecoin 约为 0.64。
矿工不接推理订单,不是不懂,是算过账。论文估计,把推理引擎和挖矿耦合在一起,会损失大约 10% 到 30% 的有效算力。也就是说,接真实推理不光要改软件、迁就请求的节奏,还得先赔掉这部分算力。币价不高的年份,这笔账很容易算成负的。
那这事有可能怎么解。论文列了几条路。一条是把表格的来源管起来,让矿工必须用外面客户交过来的表格。Pearl 官方现在做的插件和认证模型就是往这个方向走,把模型和插件递到矿工手上,你用真实模型跑推理,那份乘法顺手就把矿挖了。难处在于它是自愿的,接不接还是矿工自己算经济账。
另一条是检查表格长得像不像真的。真实模型的权重和随手填的随机数在统计特征上有差别。但论文自己把这条路否掉了,矿工只要把分布调一调就能骗过检查,成本几乎为零。还有几条更远的路都还没落地。把模型来源做成能验证的签名,得先有模型方的公钥体系。用可信硬件证明数据出处,要额外信任芯片厂商,还会拖慢速度。在奖励上做区分,用真实数据的给得多一点,这需要先有一批真愿意付钱的客户。
Pearl 的开发方是 Pearl Research Labs。Omri Weinstein 是联合创始人兼 CEO,这个头衔出自 Together AI 的合作公告。他是复杂性理论方向的研究者,希伯来大学有教职,也是那篇奠基论文的作者之一。
另一位作者 Ilan Komargodski 也在 Hugging Face 的组织成员名单里,具体身份是员工还是顾问没有公开来源可证。能对上号的还有 Erez Badash,讲 GPU 逐位复现的 Hawkeye 论文一作。
Bittensor 让验证者给矿工提交的模型输出打分,分数由一套叫 Yuma 的共识决定。io 是按需把 GPU 租给机器学习任务。Pearl 押的是一个更窄的假设,出块用的那道乘法本身可以有人要。
它赌的是推理需求会大到吃掉出块算力。到了那个程度,矿工自己会算清楚,接真实订单比填随机数字划算。吃不到,它就是一条换了数学的显卡矿链,算出来的东西和 AI 同源,和任何一个具体用户的期待无关。