TL;DR:
AI 内存短缺可能贯穿整个周期。摩根士丹利认为,模型规模、上下文长度和推理并发量持续增长,将不断吸收新增存储供应。
英伟达开始为 Rubin 提供「减配」方案。部分 HBM 和 LPDDR5 容量可能下调,但需求并未消失,而是向 NAND、DRAM 和高速互连转移。
AI 推理架构正在重构。Prefill 与 Decode 分离,有望提高硬件利用率,为 Cerebras、英伟达 Groq 等技术方案创造机会。
CXL 有望成为新的增长点。摩根士丹利预计,2030 年相关半导体市场规模约达 60 亿美元,Astera Labs 和 Marvell 是潜在受益者。
存储股的关键是周期持续时间,而非短期涨价幅度。摩根士丹利维持增持美光和闪迪,主要风险在于 AI 投资及数据中心建设放缓。
编者按:AI 的下一道瓶颈,可能不再是 GPU 数量,而是内存。随着大模型规模扩大、上下文窗口增长,以及 AI Agent 持续消耗更多推理资源,HBM、DRAM 和 NAND 的供应压力正在向整个数据中心传导。更值得关注的是,面对存储短缺,英伟达正在探索为下一代 Rubin 平台提供更低内存配置的产品方案,以维持系统交付和部署节奏。
这提出了一个看似矛盾的问题:如果 AI 对存储的需求如此旺盛,为什么芯片厂商反而开始考虑减少内存容量?内存「减配」是否意味着需求即将见顶,还是说明供应瓶颈已经严重到迫使整个产业调整技术路线?
摩根士丹利半导体分析师 Joseph Moore 等人在 10 月 5 日发布的研报《How Can the AI Ecosystem Work Around Memory Bottlenecks?》中提出,存储短缺可能持续贯穿当前 AI 周期,但 AI 建设不会等待 DRAM 晶圆厂完成扩产。行业需要通过降低部分产品配置、拆分推理任务,以及提高内存共享效率等方式,绕过现有供应限制。
这意味着,AI 硬件的竞争可能从单纯增加 GPU 和内存容量,进一步转向整个计算系统的资源利用效率。存储短缺并不必然削弱存储厂商的长期需求,却可能改变产业链的价值分配。除了美光、闪迪等存储企业,Cerebras、Astera Labs 和 Marvell 等拥有特殊计算架构及互连技术的厂商,也可能从中获得新的增长机会。
以下为原文编译:
AI 基础设施建设正在面临一个越来越难以解决的问题:算力可以通过采购更多 GPU 扩张,但内存供应并不能以同样的速度增加。
摩根士丹利认为,在可预见的未来,AI 需求可能持续吸收大量新增存储供应。即使不同时期的紧缺程度有所波动,DRAM 产能扩张仍难以迅速消除供需缺口。
在与计算行业企业的交流中,摩根士丹利发现,如何绕过内存瓶颈已成为越来越重要的话题。英伟达 CEO 黄仁勋也谈到了通过计算、网络和存储系统的协同设计缓解供应限制的必要性。
分析师认为,这不是对存储需求转弱的预警,而是整个 AI 产业不得不面对的现实:当内存无法按原计划供应时,企业必须找到新的系统架构,让现有硬件继续支持 AI 增长。
一、英伟达开始给 Rubin「减配」,存储瓶颈却没有消失最直接的办法,是减少单台服务器或单个 GPU 所使用的内存容量。
摩根士丹利指出,DRAM 和 NAND 供应紧张及价格上涨,正在迫使 AI 产业链重新考虑产品配置。对于芯片厂商而言,与其坚持原有规格、导致系统无法按计划交付,不如提供不同内存容量的版本,让客户根据实际需求选择。
研报预计,英伟达可能为 Rubin 平台提供多种较低内存配置。
在机架级内存方面,Rubin 原先规划的 LPDDR5 容量约为 54TB,而部分新配置可能降至 28TB,对应 SOCAMM2 内存模块容量从 192GB 降至 96GB。
在 HBM 方面,Rubin 单 GPU 原先预计配备 288GB HBM4,采用 8 组 12 层堆叠设计;摩根士丹利预计,英伟达可能增加配备 192GB HBM4 的产品版本,将堆叠层数降至 8 层。
对于 Rubin Ultra,研报认为,在调整为双计算芯粒方案后,512GB 是更合适的比较基准,未来可能出现约 192GB 至 384GB 的不同容量选择。
这些均属于摩根士丹利截至研报发布日对产品配置的判断,并非所有规格都已得到英伟达正式确认。
从成本角度看,这种策略有其合理性。降低 HBM 堆叠层数可以减少容量,而在接口数量和引脚速率等条件不变时,理论带宽不一定同步下降。
但容量和带宽解决的是两个不同问题。对于模型较小、上下文较短的应用,降低容量可能影响有限;但当模型越来越大、推理任务越来越复杂时,内存容量不足仍可能导致更多数据需要在不同存储层级之间转移,增加延迟或 GPU 使用量。
更重要的是,减少 HBM 并不会让 AI 原本需要处理的数据消失,只会让这些数据寻找新的存放位置。
例如,当 GPU 的 HBM 容量不足时,部分数据可能需要保存在主内存中;当机架级 LPDDR5 容量降低时,部分 KV Cache(键值缓存)需求又可能转向 NAND 闪存。
KV Cache 是大模型推理过程中用于保存历史计算信息的缓存。随着上下文变长、同时运行的请求增加,其容量需求也随之上升。
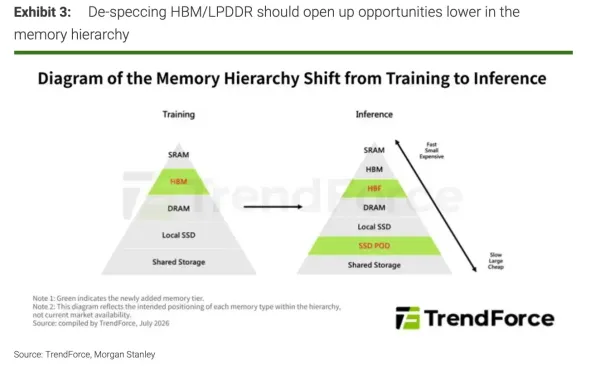
存储需求不是消失,而是向其他层级转移。
摩根士丹利指出,英伟达降低部分 LPDDR5 配置的同时,产业链已经观察到来自 NAND 的新增需求。HBM 容量减少还可能增加 GPU 间的数据传输,使高速互连网络承担更大压力。
这意味着,英伟达的减配策略可能暂时缓解 DRAM 供应约束,却同时增加对 NAND、互连芯片以及更大规模 GPU 集群的需求。
这种压力转移有其长期背景。
根据研报引用的 Epoch AI 历史数据,大语言模型时代的前沿模型参数规模曾呈现约每六个月翻倍的增长趋势。上下文窗口也经历了快速扩张。同时,更多 AI 应用从简单问答转向编程、复杂推理和长时间运行的 Agent 任务,进一步推高内存使用量。
摩根士丹利认为,模型规模、上下文长度和推理并发量将继续推动存储需求增长。因此,降低部分产品配置更可能是供应紧张时期的过渡方案,而不是 AI 内存需求长期下降的信号。
二、AI 推理开始「拆开做」,GPU 不再包办所有任务如果说减少内存配置是短期应对措施,那么改变 AI 推理的计算方式,则可能带来更深层次的产业变化。
摩根士丹利关注的第二条路径是 Disaggregated Inference(解耦式推理),即将原本集中在同一套计算系统中的不同推理任务拆开,分别交给更适合的硬件执行。
传统大模型推理主要包含两个阶段。
第一个阶段是 Prefill(预填充),即处理用户输入的提示词、文件或历史上下文,并进行大量并行计算。这一阶段通常更依赖计算性能。
第二个阶段是 Decode(解码),即模型逐个生成输出 Token。这个过程需要反复访问模型权重和 KV Cache,因此更加依赖内存带宽、容量及数据访问延迟。
过去,同一套 GPU 往往同时承担这两类任务。但随着推理需求扩大,这种配置未必总是最有效率的选择。
摩根士丹利认为,更合理的方向可能是让计算密集型硬件负责 Prefill,再由针对低延迟和高带宽优化的架构承担 Decode。
这种方式不仅能够提高硬件利用率,还可以让数据中心分别扩张两种计算资源,而不必为所有任务配置完全相同的 GPU 和 HBM。
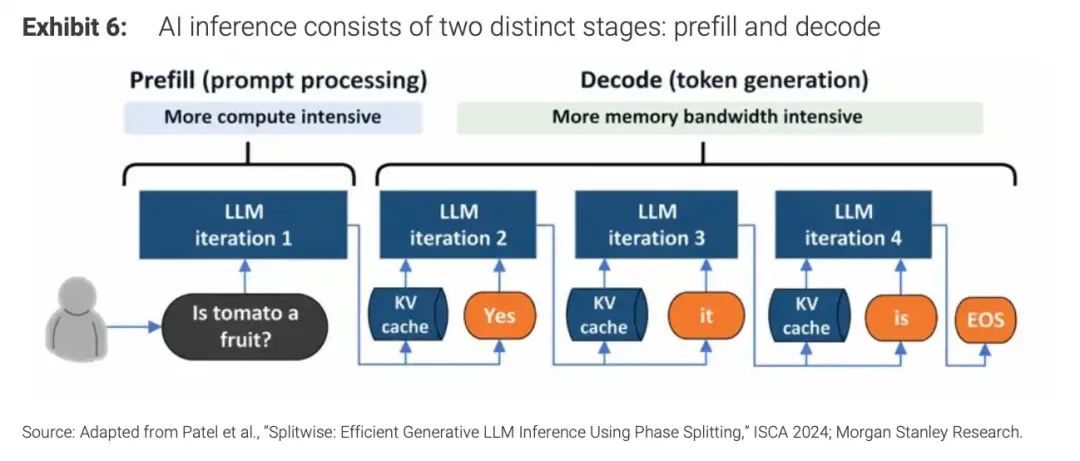
Prefill 与 Decode 的技术区别
其中最直接的潜在受益者之一是 Cerebras。
Cerebras 采用晶圆级处理器架构,将大量计算单元和 SRAM 集成在同一块芯片上。SRAM(静态随机存取存储器)容量密度通常低于 DRAM,但具备低延迟、高带宽的特点,适合某些需要频繁读取数据的推理任务。
通过让计算单元更靠近数据,Cerebras 能够减少外部内存访问需求,提高特定推理环节的处理速度。
摩根士丹利指出,Cerebras 已与 AMD、AWS 展开合作,探索将不同处理器组合成统一的推理系统。
在 AMD 与 Cerebras 的联合方案中,AMD Helios 负责更偏计算密集型的 Prefill 和大上下文处理,Cerebras 晶圆级引擎则负责 Decode。研报预计,该方案将在 2026 年第四季度进入生产阶段。
AWS 采用类似思路,通过 Trainium 处理 Prefill,再由 Cerebras 处理 Decode,相关组合方案预计于 2027 年第一季度进入 Amazon Bedrock。
根据 Cerebras 和 AMD 披露的特定方案性能数据,两者结合有望在维持 Cerebras 推理速度的同时,实现最高约五倍的吞吐量提升。这并不意味着所有推理任务都能获得同等提升,但说明针对不同任务配置硬件,可能显著改善系统经济性。
对 Cerebras 而言,这种变化不仅意味着更多芯片销售机会。由于公司还经营自己的推理云服务,如果相同硬件能够生成更多 Token,单位 Token 成本就可能下降,从而改善毛利率,或为降低客户价格提供空间。
英伟达也在探索类似方向。
通过整合 Groq 相关技术,英伟达正在将基于 HBM 的 GPU 与采用高速 SRAM 的 LPU 架构相结合。研报描述的方案中,Rubin GPU 负责 Prefill 及部分需要大容量缓存的解码计算,而 Groq 架构承担更适合其低延迟特性的运算,由 NVIDIA Dynamo 软件协调不同处理器之间的任务。
值得区分的是,英伟达与 Groq 在 2025 年达成的是技术授权及人才引进安排,并非对 Groq 公司的完整收购。
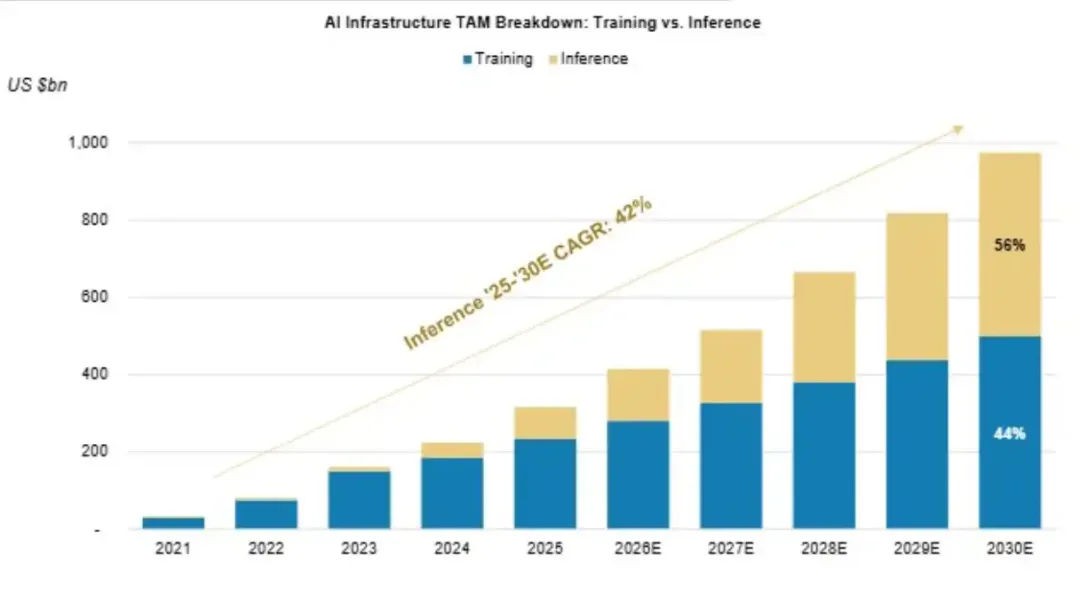
摩根士丹利认为,随着推理开支增长速度超过训练,针对不同推理环节优化的异构计算架构可能获得更大市场空间。按照研报的基础设施支出预测,到 2030 年,推理预计占 AI 基础设施支出的约 56%,训练占比约为 44%。
这也为 AI 芯片行业带来新的竞争逻辑:未来衡量一套 AI 系统竞争力的指标,可能不仅是峰值算力,还包括每秒生成多少 Token,以及生成每个 Token 需要多少成本。
除了改变推理任务的分配方式,摩根士丹利还重点关注如何提高现有内存资源的使用效率。这正是 CXL 技术的机会所在。
CXL(Compute Express Link,计算快速互连)是一种高速互连协议,能够让处理器更灵活地访问外部内存,而不必始终依赖直接连接在本地的 DRAM。
传统服务器中,内存资源往往与特定 CPU 绑定。即使一台服务器有大量闲置内存,也很难直接供另一台服务器使用。CXL 则通过内存扩展、共享和池化,提高数据中心对 DRAM 的整体利用率。其中,内存扩展可以为单个处理器提供额外容量;内存共享允许多个处理器访问相同的内存资源;内存池化则将分散的内存组织成统一资源池,根据工作负载动态分配。
这种技术过去更多应用于传统 CPU 计算环境,因为 CPU 工作负载相对更容易接受外部内存带来的额外访问延迟。相比之下,AI GPU 长期依赖 HBM 提供极高的数据带宽,CXL 连接的外部 DRAM 难以直接替代 HBM。
但随着 AI 推理需求变化,这种架构的价值正在上升。
例如,长上下文推理需要保存大量 KV Cache,但并不是所有缓存数据都必须始终留在最快的 HBM 中。系统可以将性能敏感的数据保留在 HBM,把部分访问频率较低、对延迟要求相对宽松的数据转移到外部 DRAM。
这样既可以缓解昂贵 HBM 的容量压力,也可以提高已有 DRAM 的利用效率。
摩根士丹利认为,AI 正在推动 CXL 从传统服务器内存扩展走向更广泛的加速器内存连接与共享市场。
过去,Astera Labs 曾将 CXL 内存控制器的潜在市场规模估计在 40 亿美元以上。摩根士丹利目前预计,随着 AI 推理、KV Cache 卸载和机架级内存池化需求增长,到 2030 年,CXL 及相关内存连接半导体的潜在市场规模有望达到约 60 亿美元。
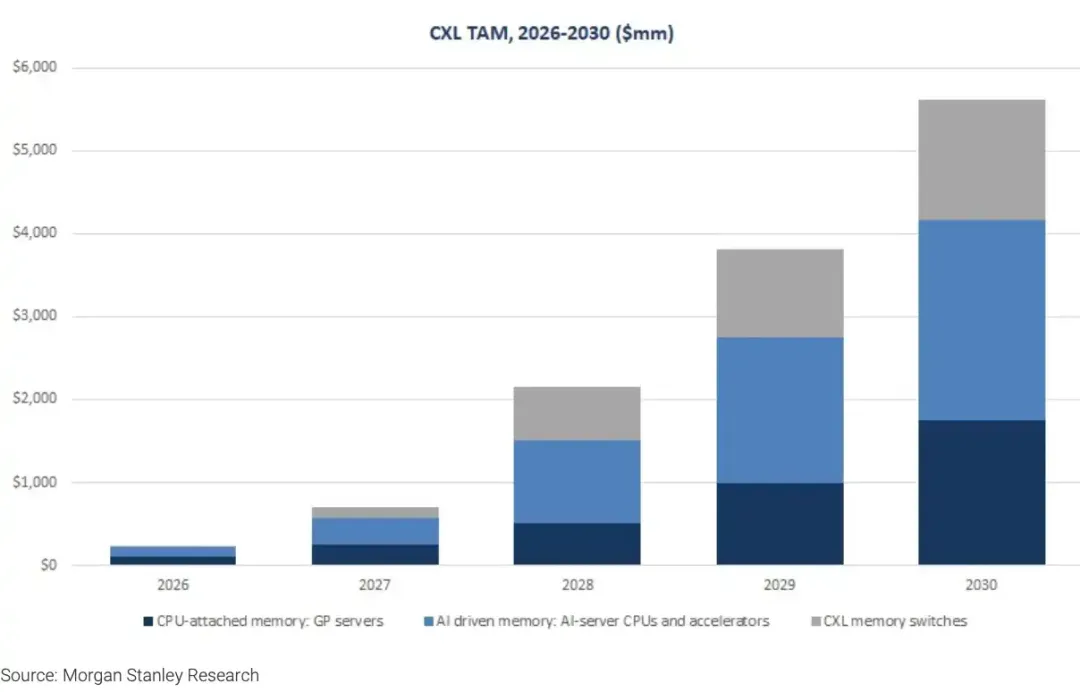
需要强调的是,这一数字属于分析师对潜在市场空间的预测,并非已经实现的市场收入。
在具体公司方面,研报重点关注 Astera Labs(ALAB)和 Marvell(MRVL)。
Astera Labs 的机会主要来自 Leo 内存控制器产品。摩根士丹利指出,公司预计标准化和定制化 Leo 产品将在 2027 年于两家美国大型云服务商客户中开始规模放量,其中包括面向 AI 推理的 KV Cache 卸载设计。
Marvell 则通过 Structera X 和 Structera S,分别布局内存扩展与机架级内存池化。公司此前预计,CXL 业务有望在 2028 年左右贡献超过 10 亿美元的收入。
对于这两家公司而言,AI 存储短缺可能使原本推广较慢的 CXL 技术获得新的商业需求。
不过,摩根士丹利也承认,CXL 市场的实际规模仍难以精确预测。不同云厂商可能选择非 CXL 互连技术、更大容量 HBM,或者基于闪存的缓存方案,最终市场采用速度可能与当前预期存在明显差异。
因此,CXL 的投资逻辑能否兑现,仍需要观察云厂商实际部署进度、产品出货量及相关业务收入。
四、内存减配未必利空美光,真正的风险是 AI 建设放缓对于存储产业链而言,英伟达降低部分内存配置似乎并不是好消息。如果单个 GPU 的 HBM 容量下降,单机架 LPDDR5 用量减少,存储厂商能够出售的内存数量就可能低于原先规划。
摩根士丹利承认,从短期利润最大化的角度看,这确实可能削弱存储厂商原本能够获得的部分需求和定价机会。但分析师认为,这不应简单理解为存储周期即将结束。关键在于,当前的减配主要是受供应约束推动,而不是因为客户不再需要那么多内存。
当 AI 厂商希望采购更多 DRAM,却无法获得足够供应时,降低配置可以帮助其维持系统交付。未来供应增加之后,厂商仍有动力重新提高配置水平。这意味着,当前未被满足的需求可能形成一定的后续采购空间。
基于这一判断,摩根士丹利更关注存储行业景气周期的持续时间,而不是短期价格上涨的最高幅度。如果 AI 模型持续扩大,Agent 应用不断增加,推理并发量继续增长,那么即使 DRAM 厂商提高产能,新增供应也可能被快速吸收。
因此,摩根士丹利维持对美光(MU)和闪迪(SNDK)的 Overweight(增持)评级,认为存储供应紧张不会迅速结束。
但这并不意味着存储行业可以完全摆脱周期风险。研报认为,最核心的风险仍然来自 AI 需求本身。如果模型开发、推理应用或算力投资增速明显下降,计算与存储产业链都可能受到冲击。
此外,还有一种更复杂的情况:AI 需求仍然旺盛,但数据中心建设因为土地、电力或基础设施限制而延迟。在这种情景下,存储产品可能已经完成生产,却因为服务器部署延后而无法按预期被消化,进而造成阶段性的供需失衡。
摩根士丹利认为,这类建设瓶颈可能对存储厂商形成额外扰动,甚至使其短期表现与部分计算芯片企业出现分化。因此,未来判断存储周期是否能够延续,不能只观察 DRAM 价格和 HBM 订单,还需要追踪 AI 基础设施的实际部署进度。
AI 存储短缺的最终影响,可能并不是让产业减少使用内存,而是迫使行业重新决定:哪些数据必须留在 HBM,哪些可以转移至 DRAM 或 NAND,以及哪些计算任务应该交给不同类型的芯片。
对于投资者而言,接下来需要关注的核心变量也逐渐清晰:Rubin 实际出货配置是否降低、解耦式推理能否实现商业化规模部署、CXL 产品能否在 2027 年按计划放量,以及 AI 数据中心建设是否继续消化新增存储供应。
如果这些技术调整能够维持 AI 系统部署,同时长期存储需求继续增长,那么存储与互连产业链可能共同受益;但如果 AI 投资放缓,或者电力与土地限制持续阻碍数据中心落地,当前的供需紧张也可能面临重新定价。
这正是摩根士丹利对本轮 AI 存储周期最重要的判断:行业真正需要解决的不是如何等待更多内存,而是如何在内存始终稀缺的情况下,继续扩大 AI 的计算能力。